O monitoramento de site combina verificações automáticas, alertas acionáveis e um plano de resposta para detectar falhas antes que clientes, leads ou equipes internas sejam afetados. Medir apenas se uma página está online não basta: é necessário acompanhar disponibilidade, desempenho, segurança, integrações e funções críticas, além de definir responsáveis pela contenção, restauração e comunicação.
Quando uma empresa descobre a indisponibilidade do site por uma mensagem de cliente, o problema não começou naquele momento. A falha já atravessou a infraestrutura, o atendimento e, possivelmente, oportunidades comerciais sem que o processo operacional reagisse.
Essa situação mostra a diferença entre contratar hospedagem, solicitar suporte quando algo quebra e manter uma operação contínua de confiabilidade. Hospedagem oferece recursos técnicos. Suporte responde a chamados dentro de um escopo. Monitoramento e resposta a incidentes formam um processo permanente de prevenção, detecção, recuperação e aprendizado.
Um site institucional estratégico pode concentrar campanhas, conteúdo, formulários, integrações, atendimento e informações comerciais. Quanto maior essa dependência, maior deve ser a capacidade de detectar incidentes, avaliar seu impacto e restaurar os serviços com segurança.
O que é monitoramento de site?
Monitoramento de site é o acompanhamento contínuo das condições técnicas e funcionais que permitem que uma propriedade digital cumpra sua finalidade. Isso inclui verificar se o domínio responde, se as páginas carregam, se os formulários funcionam, se os dados chegam aos sistemas corretos e se não há sinais relevantes de degradação ou comprometimento.
Uma verificação de uptime confirma que determinado endereço respondeu em um momento específico. Ela não garante, porém, que:
- a página carregou todos os componentes necessários;
- o formulário enviou os dados corretamente;
- o CRM recebeu o lead;
- o checkout concluiu uma compra;
- o certificado SSL está próximo do vencimento;
- o banco de dados opera sem erros;
- o site oferece boa experiência para usuários reais;
- não houve alteração indevida de arquivos ou usuários.
Por isso, o monitoramento deve ser construído em camadas. Essa organização ajuda a diferenciar uma falha de infraestrutura de um problema de aplicação, conteúdo, segurança ou integração.
O que acompanhar no monitoramento de site?
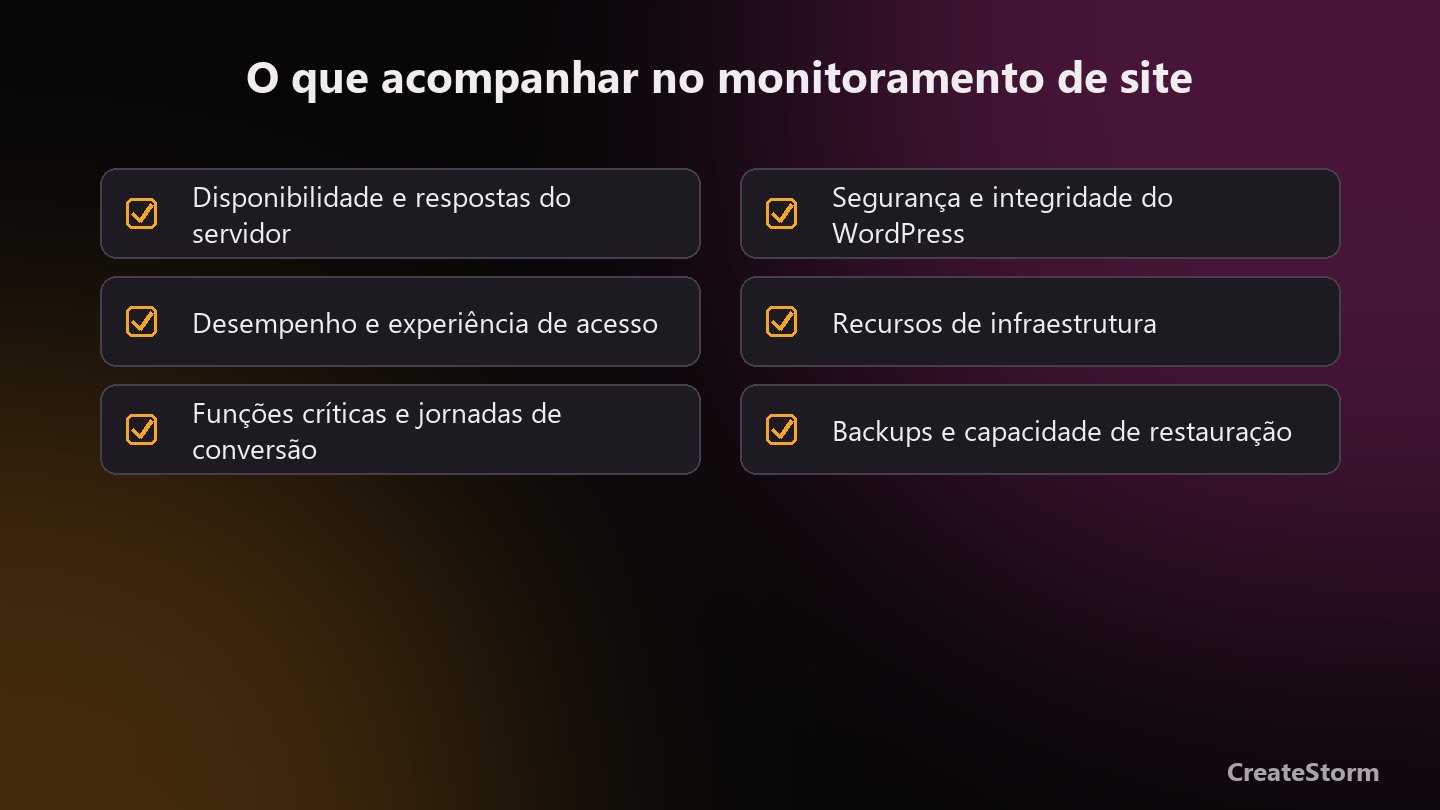
Disponibilidade e respostas do servidor
O primeiro nível verifica se páginas e serviços essenciais estão acessíveis. Os principais sinais incluem:
- resposta do domínio;
- códigos HTTP;
- tempo de conexão;
- resolução de DNS;
- validade do certificado SSL;
- redirecionamentos inesperados;
- indisponibilidade regional;
- falhas recorrentes ou intermitentes.
O uptime de site deve ser medido a partir de um ponto externo à hospedagem. Uma verificação executada apenas dentro do próprio servidor pode indicar normalidade mesmo quando visitantes não conseguem acessar o domínio.
Em sites com maior relevância comercial, vale utilizar verificações de mais de uma região ou provedor. Isso ajuda a distinguir uma indisponibilidade geral de uma falha localizada de rede, DNS ou CDN.
Desempenho e experiência de acesso
Um site pode estar tecnicamente online e, ainda assim, apresentar lentidão suficiente para prejudicar navegação, conversões e percepção de qualidade. O monitoramento deve registrar tempo de resposta, duração do carregamento e mudanças relevantes nas páginas prioritárias.
Há duas perspectivas complementares:
- monitoramento sintético: executa testes controlados, em intervalos definidos, a partir de dispositivos e redes simulados;
- monitoramento de usuários reais: registra como visitantes efetivos experimentam carregamento, interatividade e estabilidade visual.
Ferramentas como o PageSpeed Insights combinam dados de laboratório e, quando disponíveis, informações de experiência real. Esses dados não substituem o monitoramento contínuo, mas ajudam a identificar tendências e diferenças entre uma simulação controlada e o comportamento observado pelos usuários.
O objetivo não é transformar toda oscilação em incidente crítico. É comparar o comportamento atual com uma linha de base e reconhecer degradações persistentes, principalmente após atualizações, mudanças de infraestrutura ou lançamento de campanhas.
Funções críticas e jornadas de conversão
O monitoramento funcional simula ações que possuem valor comercial ou operacional. Dependendo do site, isso pode envolver:
- abrir uma página de campanha;
- enviar um formulário de contato;
- confirmar a mensagem de sucesso;
- validar a criação do lead no CRM;
- testar autenticação e áreas restritas;
- realizar uma busca interna;
- iniciar ou concluir uma compra de teste;
- verificar downloads ou emissão de documentos;
- confirmar o disparo de notificações e e-mails.
Uma mensagem de sucesso na interface não prova que o processo foi concluído. O formulário pode responder normalmente enquanto a integração com o CRM está interrompida.
Por isso, projetos de integração entre CRM e site precisam incluir rastreabilidade, registros de execução, tratamento de erros e mecanismos seguros para reprocessar dados.
Segurança e integridade do WordPress
No monitoramento WordPress, também devem ser acompanhados:
- alterações inesperadas em arquivos;
- criação de usuários administrativos;
- tentativas anormais de autenticação;
- vulnerabilidades conhecidas em plugins e temas;
- falhas de atualização;
- mudanças não autorizadas em configurações;
- redirecionamentos ou conteúdos suspeitos;
- comportamento incomum do servidor;
- erros recorrentes de PHP ou banco de dados.
A documentação oficial do WordPress recomenda manter o núcleo, os plugins e os temas atualizados, além de trabalhar com fontes confiáveis e controles de recuperação. Essas medidas devem fazer parte de uma arquitetura mais ampla de proteção, como a combinação de WordPress, Cloudflare e hospedagem cloud.
Recursos de infraestrutura
Espaço em disco, memória, processamento, banco de dados, filas, tarefas agendadas e erros de aplicação ajudam a identificar problemas antes da indisponibilidade total.
Alguns exemplos de sinais preventivos são:
- disco próximo da capacidade máxima;
- crescimento anormal do banco de dados;
- consumo excessivo de memória;
- processos bloqueados;
- tarefas agendadas que deixaram de executar;
- aumento persistente no tempo de resposta;
- erros repetidos em uma mesma integração;
- crescimento inesperado de arquivos de log.
Esses sinais permitem agir antes que a falha se transforme em uma indisponibilidade completa.
Backups e capacidade de restauração
Não basta agendar um backup. É necessário confirmar:
- se a execução foi concluída;
- quais arquivos e bancos foram incluídos;
- onde a cópia está armazenada;
- por quanto tempo será mantida;
- se existem cópias externas ao servidor principal;
- se os arquivos podem ser restaurados;
- quando ocorreu o último teste de recuperação.
A documentação oficial do WordPress recomenda backups regulares e cópias antes de atualizações ou migrações. O teste de restauração é indispensável porque um arquivo existente pode estar incompleto, corrompido ou incompatível com o ambiente atual.
Como classificar a severidade de um incidente?
A severidade deve representar o impacto no negócio, e não apenas a complexidade técnica. Um erro simples que interrompe todos os formulários pode ser mais grave do que uma falha sofisticada em uma página sem tráfego ou função comercial.
Uma matriz objetiva impede que toda notificação seja tratada como emergência e evita que uma interrupção relevante fique perdida em uma fila comum de suporte.
| Nível | Exemplo de impacto | Resposta esperada |
|---|---|---|
| Severidade 1 — crítica | Site indisponível, possível comprometimento, perda de dados, checkout ou conversão principal totalmente interrompidos. | Acionamento imediato, coordenação central, contenção e atualizações frequentes até a estabilização. |
| Severidade 2 — alta | Função importante degradada, formulários com falha, integração comercial interrompida ou área relevante inacessível. | Investigação prioritária, medida de contenção e atualização aos responsáveis afetados. |
| Severidade 3 — moderada | Erro localizado, lentidão sem interrupção ampla ou problema com alternativa temporária disponível. | Registro, diagnóstico e correção no fluxo operacional definido. |
| Severidade 4 — baixa | Anomalia estética, aviso preventivo ou desvio sem impacto material imediato. | Triagem, agrupamento e tratamento planejado. |
Os níveis e prazos precisam ser adaptados à realidade de cada operação. Um portal informativo, uma landing page durante uma campanha e uma loja virtual apresentam riscos diferentes.
A classificação também pode mudar durante a investigação. Um alerta inicialmente moderado pode se tornar crítico quando a equipe confirma que a falha afeta várias páginas, expõe informações ou impede a entrada de leads.
Conte com nossa experiência em desenvolvimento web e mobile para estruturar seu projeto digital com segurança.
Quais métricas ajudam a avaliar a resposta?
A operação precisa medir não apenas quantos incidentes ocorreram, mas quanto tempo levou para reconhecê-los, reagir e recuperar o serviço.
- MTTD — tempo médio para detectar: intervalo entre o início estimado da falha e sua identificação.
- MTTA — tempo médio para assumir: período entre o alerta e o momento em que um responsável inicia a atuação.
- MTTR — tempo médio para restaurar: tempo necessário para recuperar o serviço ou função afetada.
- Taxa de alertas falsos: proporção de notificações que não representam impacto real.
- Recorrência: quantidade de incidentes repetidos pela mesma causa ou condição.
- Detecção interna: percentual de falhas identificadas pelo monitoramento antes de relatos de usuários.
Essas métricas devem ser interpretadas em contexto. Reduzir o tempo de restauração é importante, mas não pode estimular correções apressadas que apagam evidências, causam perda de dados ou introduzem uma nova falha.
Quem recebe os alertas?
Enviar todos os alertas a todas as pessoas produz ruído e dilui a responsabilidade. Uma operação eficaz encaminha cada evento para quem consegue interpretar o sinal e executar a próxima ação.
O fluxo normalmente envolve quatro papéis, ainda que uma mesma pessoa acumule funções em equipes menores:
- responsável de plantão: recebe o alerta, verifica se a falha é real e inicia o diagnóstico;
- coordenador do incidente: organiza prioridades, registra decisões e evita ações conflitantes;
- responsável de negócio: avalia efeitos sobre campanhas, atendimento, vendas e clientes;
- responsável pela comunicação: consolida informações e mantém as partes envolvidas atualizadas.
A rota de escalonamento deve considerar severidade e tempo sem resolução. Um certificado próximo do vencimento pode gerar uma tarefa planejada. Uma indisponibilidade confirmada deve alcançar imediatamente a equipe operacional.
Um alerta sem responsável, contexto e próxima ação é apenas uma notificação. Monitoramento útil precisa terminar em uma decisão operacional.
Essa governança se torna especialmente importante quando o site participa diretamente do funil de vendas B2B. Marketing, tecnologia e comercial podem precisar de informações diferentes, mas devem trabalhar com a mesma situação confirmada.
Como responder a incidentes em 7 etapas?
A resposta a incidentes WordPress deve seguir uma sequência previsível mesmo quando a causa ainda é desconhecida. Processos improvisados aumentam o tempo de recuperação e podem introduzir novos erros.
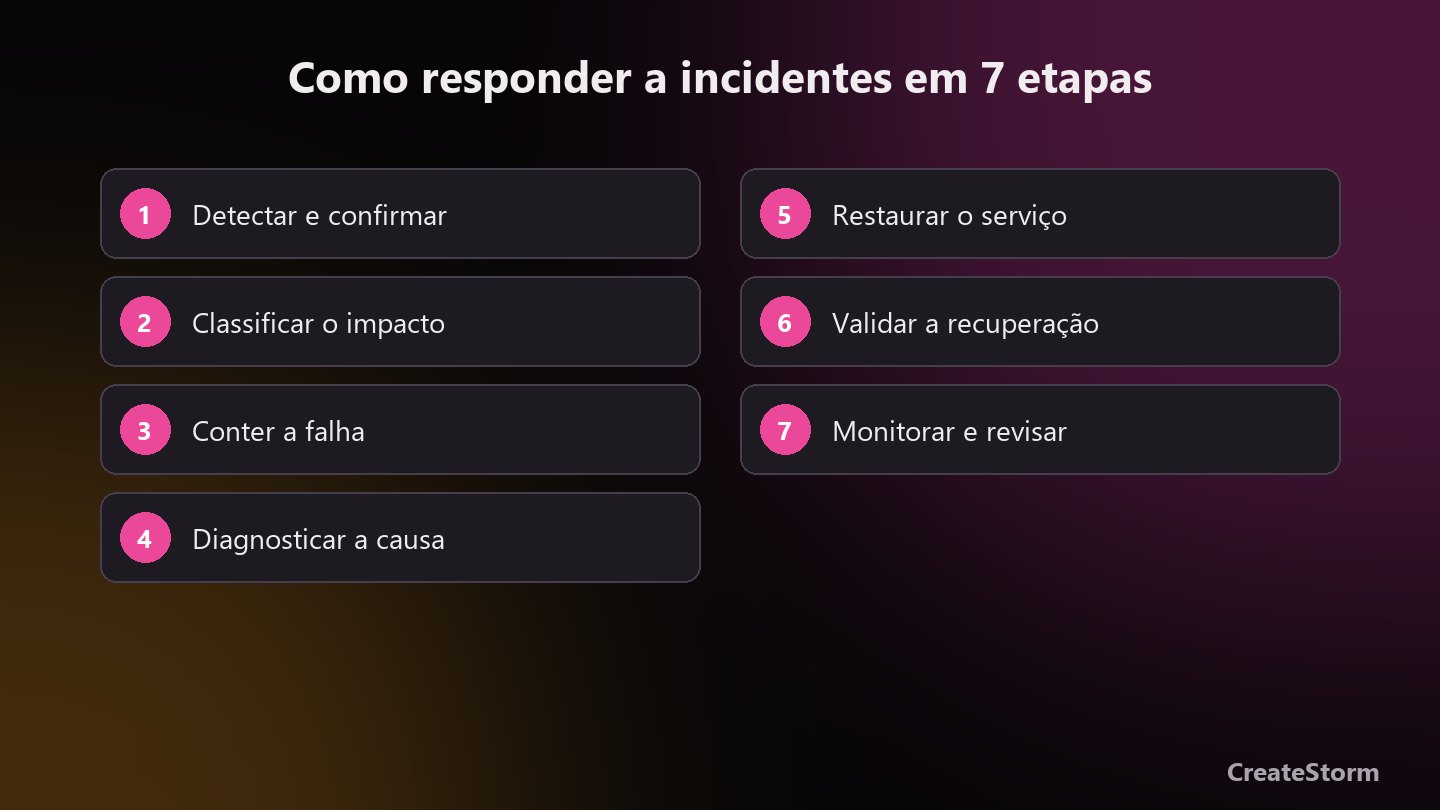
1. Detectar e confirmar
Valide o alerta por uma segunda tentativa, outra origem ou teste funcional. Identifique o serviço afetado e abra um registro com horário, sintomas e evidências iniciais.
2. Classificar o impacto
Avalie quantos usuários foram afetados, quais funções estão interrompidas, se há risco de segurança ou dados e se existe uma alternativa temporária.
3. Conter a falha
Limite a propagação do problema. Dependendo do caso, isso pode envolver desativar uma função, bloquear acessos, interromper uma integração ou reverter uma alteração recente.
A contenção não é necessariamente a solução definitiva. Ela cria condições para investigar e recuperar o serviço com menor risco.
4. Diagnosticar a causa
Analise logs, alterações recentes, dependências externas, recursos do servidor e eventos anteriores. Preserve evidências relevantes, principalmente quando houver suspeita de comprometimento.
Evite várias pessoas modificando o ambiente simultaneamente sem coordenação. Cada ação precisa ter responsável, horário, justificativa e resultado registrados.
5. Restaurar o serviço
A recuperação pode ocorrer por reversão, correção, restauração de backup, substituição de componente ou ativação de uma alternativa temporária.
A decisão precisa considerar a integridade dos dados. Restaurar rapidamente uma versão antiga pode recolocar o site online, mas também apagar registros criados depois daquele backup.
6. Validar a recuperação
Não encerre o incidente apenas porque a página inicial voltou a abrir. Teste:
- páginas prioritárias;
- formulários;
- integrações;
- painel administrativo;
- acesso móvel;
- cache e CDN;
- tarefas agendadas;
- plugins essenciais;
- e-mails e notificações;
- registros criados durante os testes.
7. Monitorar e revisar
Após a restauração, observe o ambiente por um período suficiente para confirmar que a falha não retornou. Depois, documente a linha do tempo, a causa identificada, as decisões e as ações preventivas.
A orientação atual do NIST para resposta a incidentes trata preparação, detecção, resposta, recuperação e melhoria como partes conectadas do gerenciamento contínuo de riscos. O encerramento técnico não encerra o processo até que os aprendizados sejam incorporados.
Como comunicar um incidente?
A comunicação deve ser proporcional ao impacto e baseada em fatos confirmados. O objetivo não é narrar toda a investigação técnica, mas informar:
- o que foi detectado;
- qual serviço ou função está afetado;
- qual impacto é conhecido;
- o que a equipe está fazendo;
- quando ocorrerá a próxima atualização;
- quem coordena a resposta.
Quando a causa ainda não estiver confirmada, isso deve ser informado claramente. Hipóteses técnicas não podem ser apresentadas como conclusões.
Também é recomendável evitar promessas de restauração sem base operacional. Uma previsão precipitada pode gerar mais ruído do que uma atualização transparente sobre a investigação.
Nem todo evento exige aviso amplo. Alertas falsos, oscilações breves sem efeito material e falhas corrigidas automaticamente podem permanecer no relatório operacional. Em contrapartida, interrupções perceptíveis, riscos de segurança, perda potencial de dados ou impactos comerciais relevantes exigem comunicação ativa.
Após a recuperação, a mensagem de encerramento deve confirmar:
- quais funções foram restauradas;
- quais testes foram executados;
- se o ambiente continua em observação;
- se haverá análise posterior;
- quando será compartilhada uma atualização definitiva.
O que incluir no post-mortem?
O post-mortem é a análise posterior ao incidente. Seu objetivo não é procurar um culpado, mas transformar uma falha real em melhoria de arquitetura, processo, monitoramento e comunicação.
O documento deve incluir:
- resumo executivo: descrição objetiva do ocorrido e do impacto;
- linha do tempo: início estimado, detecção, ações, restauração e encerramento;
- causa raiz: condição principal que permitiu o incidente, quando identificada;
- fatores contribuintes: condições que ampliaram o impacto ou atrasaram a recuperação;
- método de detecção: alerta automático, equipe, fornecedor ou relato de usuário;
- avaliação da resposta: o que funcionou e o que atrasou;
- ações corretivas: mudanças técnicas e processuais, com responsável e prazo;
- ações preventivas: novos testes, alertas, documentação ou treinamento;
- acompanhamento: forma de confirmar que as melhorias foram concluídas.
A análise deve ir além da causa imediata. Se uma atualização derrubou o site, não basta registrar que um plugin apresentou erro. É necessário entender:
- por que a incompatibilidade não foi detectada antes;
- se havia ambiente de teste;
- por que a reversão demorou;
- se o backup estava adequado;
- por que o monitoramento não reconheceu a função afetada;
- como impedir que a mesma situação se repita.
Hospedagem, suporte e operação contínua são diferentes
| Camada | Função principal | Limitação comum |
|---|---|---|
| Hospedagem | Disponibilizar infraestrutura, rede e recursos contratados. | Não necessariamente testa formulários, conteúdo ou integrações comerciais. |
| Suporte | Atender solicitações e corrigir problemas dentro de um escopo. | Pode depender de alguém perceber e reportar a falha. |
| Operação contínua | Monitorar, prevenir, responder, restaurar e melhorar. | Exige processos, responsáveis, documentação e indicadores. |
A operação contínua não promete ausência total de falhas. Sites dependem de infraestrutura, software, pessoas e serviços externos. O objetivo é reduzir o tempo entre falha e detecção, recuperar funções com segurança e diminuir a probabilidade de recorrência.
Para sites em WordPress, essa abordagem complementa as práticas de otimização de um site WordPress. A tecnologia é parte da solução, mas a confiabilidade depende de como o ambiente é acompanhado depois da publicação.
Como montar um plano de resposta a incidentes?
Um plano de resposta a incidentes deve ser curto o suficiente para consulta durante uma falha e detalhado o bastante para eliminar dúvidas críticas.
- Liste páginas, sistemas, integrações e jornadas essenciais.
- Defina indicadores e limites de alerta para cada componente.
- Crie níveis de severidade baseados no impacto.
- Associe responsáveis, substitutos e canais de escalonamento.
- Documente procedimentos de contenção, reversão e restauração.
- Defina quando e para quem comunicar.
- Teste backups e funções essenciais.
- Realize simulações com cenários plausíveis.
- Revise o plano depois de mudanças e incidentes reais.
O plano não deve ficar armazenado apenas dentro do sistema que pode se tornar indisponível. Contatos, acessos emergenciais, documentação de recuperação e responsabilidades precisam continuar acessíveis durante a ocorrência.
Como aplicar Criar → Otimizar → Escalar ao monitoramento?
- Criar: mapear ativos críticos, configurar backups, definir responsabilidades e estabelecer uma linha de base.
- Otimizar: reduzir alertas falsos, melhorar desempenho, corrigir fragilidades e testar restaurações.
- Escalar: automatizar verificações, centralizar registros, acompanhar indicadores e incorporar aprendizados.
Essa sequência evita instalar ferramentas sem um processo operacional. O valor do monitoramento não está na quantidade de notificações, mas na capacidade de transformar sinais em decisões e ações coordenadas.
Perguntas frequentes sobre monitoramento de site
Uptime é a única métrica necessária?
Não. O uptime informa se um endereço respondeu, mas deve ser combinado com desempenho, segurança, integridade, recursos do servidor e testes de funções como formulários, checkout e integrações.
Com que frequência o site deve ser verificado?
A frequência depende da criticidade. Serviços essenciais exigem verificações automatizadas mais frequentes. Análises de capacidade, atualizações, segurança e testes de restauração podem seguir ciclos operacionais planejados.
O cliente deve ser avisado sobre toda falha?
Não necessariamente. A comunicação deve considerar impacto, duração, risco e percepção do usuário. Eventos sem efeito material podem permanecer no registro ou relatório operacional.
Como reduzir alertas falsos?
Confirme a falha por mais de uma tentativa ou origem, ajuste limites com base no comportamento normal e diferencie oscilações breves de eventos persistentes. Todo alerta recorrente que não gera ação deve ser revisado.
Qual é a diferença entre suporte e operação contínua?
O suporte normalmente reage a solicitações dentro de um escopo. A operação contínua monitora de forma proativa, coordena incidentes, valida restaurações e transforma aprendizados em melhorias preventivas.
Um backup automático é suficiente?
Não. A equipe precisa confirmar execução, retenção, integridade, armazenamento externo e capacidade de restauração. Um backup que nunca foi testado não oferece garantia de recuperação.
Monitoramento impede que o site fique fora do ar?
Não. O monitoramento reduz o tempo de detecção e melhora a capacidade de resposta. Prevenção, redundância, manutenção, segurança e testes são necessários para reduzir a frequência e o impacto das falhas.
Como reduzir o impacto operacional das falhas?
Reduzir impacto exige conectar tecnologia, processo e responsabilidade. O site precisa ser monitorado a partir das funções que sustentam a operação, e não apenas por uma verificação genérica de disponibilidade.
A CreateStorm implanta e evolui ativos digitais com monitoramento, manutenção preventiva, segurança, documentação e resposta coordenada. O objetivo é identificar fragilidades antes que se transformem em interrupções prolongadas e criar uma operação capaz de recuperar serviços com segurança.
Diagnóstico de citabilidade
Sua marca oferece sinais suficientes para ser lembrada e citada?
Use o diagnóstico gratuito para identificar oportunidades de clareza, entidade e evidência.
Analisar citabilidade